ในโลกที่เทคโนโลยีปัญญาประดิษฐ์ (AI) ไม่ได้เป็นเพียงแนวคิดล้ำยุคอีกต่อไป แต่ได้กลายเป็นเครื่องมือสำคัญที่ขับเคลื่อนนวัตกรรมและประสิทธิภาพในหลากหลายอุตสาหกรรม โดยเฉพาะอย่างยิ่งในสายงานการพัฒนาซอฟต์แวร์และ DevOps การบริหารจัดการทรัพยากรและต้นทุนที่เกี่ยวข้องกับ AI กำลังทวีความสำคัญมากขึ้นเรื่อยๆ
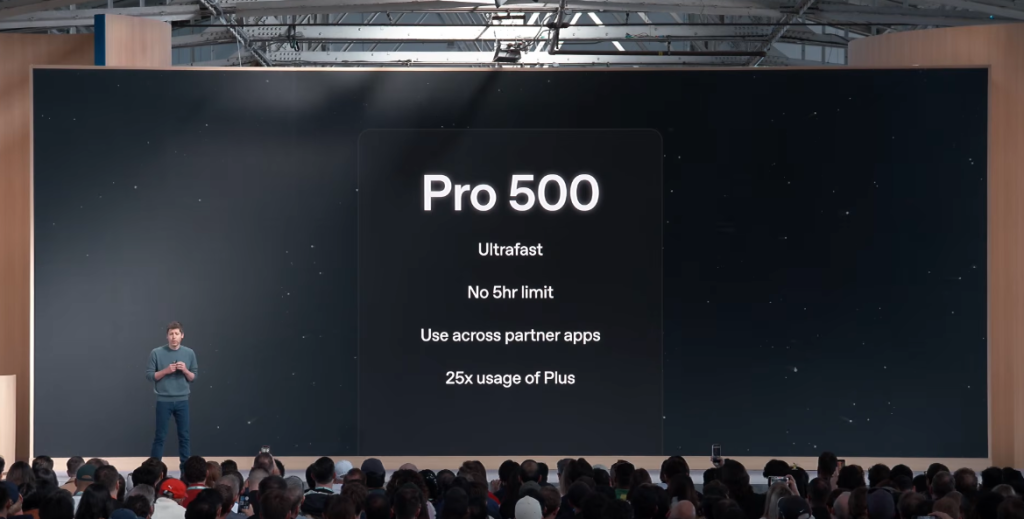
เมื่อไม่นานมานี้ OpenAI ผู้บุกเบิกในวงการ AI ได้ประกาศการเปลี่ยนแปลงที่สำคัญเกี่ยวกับแผนการใช้งาน API ของพวกเขา โดยมีการลดโควตาการใช้งานสำหรับแพ็กเกจ 200 ดอลลาร์สหรัฐฯ ต่อเดือนลงครึ่งหนึ่ง พร้อมกับการเปิดตัวแพ็กเกจใหม่ในราคา 500 ดอลลาร์สหรัฐฯ ต่อเดือน ที่มาพร้อมกับโควตาการใช้งานที่สูงขึ้นและการเข้าถึงที่ได้รับความสำคัญ สิ่งนี้ไม่ใช่แค่การปรับราคาธรรมดา แต่เป็นสัญญาณที่ชัดเจนว่าการใช้งาน AI กำลังเข้าสู่ยุคที่ต้องมีการวางแผนและบริหารจัดการอย่างรอบคอบ โดยเฉพาะอย่างยิ่งสำหรับทีม DevOps ที่มักจะใช้ AI ในกระบวนการอัตโนมัติ การทดสอบ และการเพิ่มประสิทธิภาพ
บทความนี้จะเจาะลึกถึงนัยยะของการเปลี่ยนแปลงครั้งนี้ วิเคราะห์ผลกระทบต่อการทำงานของนักพัฒนาและองค์กรไทยในมุมมองของ DevOps พร้อมเสนอแนวทางปฏิบัติเพื่อรับมือและปรับตัวให้เข้ากับภูมิทัศน์ใหม่ของ AI as a Service
การเปลี่ยนแปลงแผนการใช้งาน OpenAI: รายละเอียดและนัยยะ
ก่อนหน้านี้ OpenAI มีแพ็กเกจการใช้งานสำหรับนักพัฒนาและองค์กรที่ต้องการเข้าถึง API ของพวกเขา หนึ่งในแพ็กเกจยอดนิยมคือแพ็กเกจ 200 ดอลลาร์สหรัฐฯ ต่อเดือน ซึ่งให้โควตาการใช้งานที่ค่อนข้างสูง อย่างไรก็ตาม การปรับเปลี่ยนล่าสุดได้ลดโควตาเหล่านั้นลงอย่างมีนัยสำคัญ ส่งผลให้ผู้ใช้งานเดิมอาจพบว่าตนเองถึงขีดจำกัดเร็วขึ้น และอาจต้องจ่ายเงินเพิ่มหากต้องการรักษาระดับการใช้งานเดิม
ในขณะเดียวกัน การเปิดตัวแพ็กเกจ “Pro plan” ในราคา 500 ดอลลาร์สหรัฐฯ ต่อเดือน ถือเป็นการตอบสนองต่อความต้องการของลูกค้าองค์กรหรือผู้ใช้งานที่มีปริมาณการใช้งานสูง โดยแพ็กเกจนี้มอบโควตาการใช้งานสูงสุด และที่สำคัญคือ “priority access” ซึ่งหมายถึงการเข้าถึงทรัพยากรได้ก่อนในช่วงเวลาที่มีความต้องการสูง (peak demand) สิ่งนี้มีความสำคัญอย่างยิ่งสำหรับแอปพลิเคชันหรือระบบที่ต้องพึ่งพา AI ในการดำเนินงานที่สำคัญและต้องการความเสถียรสูง
ตารางเปรียบเทียบแผนการใช้งาน OpenAI (ประมาณการจากข้อมูลเบื้องต้น)
| คุณสมบัติ | แผนเดิม ($200/เดือน) | แผนใหม่ ($200/เดือน) | Pro Plan ใหม่ ($500/เดือน) |
|---|---|---|---|
| ราคาต่อเดือน | $200 USD | $200 USD | $500 USD |
| โควตาการใช้งาน (Allowance) | สูง (อ้างอิงจากข้อมูลก่อนปรับลด) | ปานกลาง (ลดลงครึ่งหนึ่งจากเดิม) | สูงสุด |
| Priority Access | ไม่มี | ไม่มี | มี (เข้าถึงทรัพยากรได้ก่อน) |
| เหมาะสำหรับ | นักพัฒนา, SME ที่มีใช้งานปานกลางถึงสูง | นักพัฒนา, SME ที่มีใช้งานเบื้องต้นถึงปานกลาง | องค์กรขนาดใหญ่, แอปพลิเคชันที่ต้องการความเสถียรสูง, MLOps ระดับ Production |
| ผลกระทบหลัก | คุ้มค่าสำหรับผู้ใช้งานจำนวนมาก | อาจถึงขีดจำกัดเร็วขึ้น, ต้องบริหารจัดการการใช้งานเข้มงวดขึ้น | ต้นทุนสูงขึ้น แต่ได้ความมั่นใจในประสิทธิภาพ |
การปรับเปลี่ยนนี้สะท้อนให้เห็นว่า OpenAI กำลังปรับกลยุทธ์เพื่อให้บริการลูกค้ากลุ่มองค์กรที่ต้องการความน่าเชื่อถือและประสิทธิภาพสูงสุด ในขณะเดียวกันก็ผลักดันให้ผู้ใช้งานรายย่อยหรือ SME ต้องพิจารณาการใช้ทรัพยากร AI อย่างมีประสิทธิภาพมากขึ้น
ผลกระทบต่อ DevOps: การบริหารจัดการต้นทุนและประสิทธิภาพ AI
ในสายงาน DevOps การนำ AI มาประยุกต์ใช้ได้หลากหลาย ไม่ว่าจะเป็นการสร้าง Code Reviews อัตโนมัติ, การสร้าง Test Cases, การวิเคราะห์ Log, การสร้าง Documentation, หรือแม้กระทั่งการเป็นส่วนหนึ่งของ MLOps Pipeline ที่ซับซ้อน การเปลี่ยนแปลงราคาและโควตาของ OpenAI จึงส่งผลกระทบโดยตรงต่อหลายมิติในกระบวนการ DevOps
การบริหารจัดการต้นทุน AI ใน CI/CD และ MLOps
สำหรับทีม DevOps ที่ผนวก OpenAI API เข้าไปในกระบวนการ Continuous Integration/Continuous Deployment (CI/CD) หรือ MLOps Pipeline การลดโควตาอาจทำให้ต้นทุนพุ่งสูงขึ้นอย่างรวดเร็ว ตัวอย่างเช่น:
- **Automated Code Review:** หากใช้ AI เพื่อตรวจสอบโค้ดในทุก Pull Request หรือทุก Commit การเรียกใช้ API จำนวนมากอาจทำให้ถึงขีดจำกัดได้ง่ายขึ้น
- **Test Case Generation:** การสร้าง Test Cases หรือ Mock Data โดยใช้ AI ในระหว่าง Development หรือ Testing Phase ก็จะกินโควตาอย่างรวดเร็ว
- **Documentation & Knowledge Base:** การใช้ AI เพื่อสร้างหรืออัปเดตเอกสารประกอบโปรเจกต์อัตโนมัติ
- **Log Analysis & Alerting:** การส่ง Log ไปให้ AI วิเคราะห์เพื่อหาความผิดปกติหรือสร้าง Summary
เดิมที ทีมอาจจะไม่ได้ให้ความสำคัญกับการบริหารจัดการ Token Usage มากนัก แต่ตอนนี้กลายเป็นสิ่งจำเป็น การนำเสนอแพ็กเกจ 500 ดอลลาร์ฯ ก็แสดงให้เห็นว่า OpenAI มองเห็นความต้องการด้านประสิทธิภาพและ SLA (Service Level Agreement) ที่สูงขึ้นในระดับองค์กร ซึ่งทีม DevOps จะต้องประเมินว่าแอปพลิเคชันใดที่สำคัญพอที่จะลงทุนในแพ็กเกจที่แพงกว่า เพื่อให้มั่นใจในความต่อเนื่องของธุรกิจ
ความท้าทายด้าน Resource Allocation และ Performance Stability
Priority Access ของ Pro Plan ไม่ใช่แค่เรื่องของปริมาณ แต่เป็นเรื่องของคุณภาพการเข้าถึง การที่ API ตอบสนองได้รวดเร็วและสม่ำเสมอเป็นสิ่งสำคัญอย่างยิ่งสำหรับระบบ Production หากระบบ AI ของคุณเป็นส่วนหนึ่งของ Critical Path ในแอปพลิเคชัน เช่น การประมวลผลคำสั่งซื้อของลูกค้า หรือระบบ Customer Support ที่ใช้ AI Chatbot การที่ API ถูก Throttling หรือมีความหน่วงสูงอาจส่งผลกระทบโดยตรงต่อประสบการณ์ผู้ใช้และรายได้
ทีม DevOps จึงต้องพิจารณาว่าระบบใดบ้างที่ต้องการ Priority Access และจัดสรรงบประมาณให้เหมาะสม สำหรับระบบที่ไม่วิกฤติมากนัก อาจจะยังคงใช้แพ็กเกจ 200 ดอลลาร์ฯ และเพิ่มกลไกในการจัดการ Rate Limit หรือ Caching เพื่อลดการพึ่งพา API โดยตรง
ตัวอย่างการติดตามการใช้งาน OpenAI API ใน DevOps
การติดตามและควบคุมการใช้งานเป็นหัวใจสำคัญ ทีม DevOps สามารถนำเครื่องมือต่างๆ มาใช้ในการมอนิเตอร์และแจ้งเตือนเมื่อมีการใช้งานใกล้ถึงขีดจำกัด หรือเกินงบประมาณที่ตั้งไว้ นี่คือตัวอย่างสคริปต์ Python ง่ายๆ ที่สามารถใช้ตรวจสอบการใช้งาน OpenAI API
import os
import requests
import json
from datetime import datetime, timedelta

# ตั้งค่า API Key และ Organization ID
OPENAI_API_KEY = os.getenv("OPENAI_API_KEY")
OPENAI_ORG_ID = os.getenv("OPENAI_ORG_ID") # Optional, but good practice

if not OPENAI_API_KEY:
    raise ValueError("OPENAI_API_KEY environment variable not set.")

# กำหนดช่วงเวลาที่ต้องการตรวจสอบ (เช่น 30 วันย้อนหลัง)
end_date = datetime.now()
start_date = end_date - timedelta(days=30)

url = "https://api.openai.com/v1/usage"
headers = {
    "Authorization": f"Bearer {OPENAI_API_KEY}",
    "OpenAI-Organization": OPENAI_ORG_ID # หากมี
}
params = {
    "start_date": start_date.strftime("%Y-%m-%d"),
    "end_date": end_date.strftime("%Y-%m-%d")
}

try:
    response = requests.get(url, headers=headers, params=params)
    response.raise_for_status() # Raise an HTTPError for bad responses (4xx or 5xx)
    usage_data = response.json()

    # แสดงผลข้อมูลการใช้งานรวม
    print(f"--- OpenAI API Usage Report ({start_date.strftime('%Y-%m-%d')} to {end_date.strftime('%Y-%m-%d')}) ---")
    print(f"Total Usage: ${usage_data.get('total_usage', 0) / 100:.2f} USD") # Usage is in cents

    # แสดงรายละเอียดการใช้งานรายวัน/รายโมเดล
    print("\nDetailed Daily Usage:")
    for daily_item in usage_data.get('daily_costs', []):
        date = daily_item.get('date')
        usd_cost = daily_item.get('cost', 0) / 100
        print(f"  Date: {date}, Cost: ${usd_cost:.2f} USD")
        for model_usage in daily_item.get('usage', []):
            model_name = model_usage.get('snapshot_id')
            tokens_prompt = model_usage.get('prompt_tokens', 0)
            tokens_completion = model_usage.get('completion_tokens', 0)
            print(f"    - Model: {model_name}, Prompt Tokens: {tokens_prompt}, Completion Tokens: {tokens_completion}")

    # สามารถนำข้อมูลนี้ไปเชื่อมต่อกับระบบ Monitoring เช่น Prometheus, Grafana หรือส่งแจ้งเตือนผ่าน Slack/Line ได้
    # เช่น หาก total_usage เกิน $150 ให้ส่งแจ้งเตือน
    total_cost = usage_data.get('total_usage', 0) / 100
    if total_cost > 150:
        print(f"\nWARNING: Current usage ${total_cost:.2f} USD is approaching the $200 plan limit!")
        # TODO: Implement notification logic here (e.g., send_slack_message("Usage Alert!"))

except requests.exceptions.HTTPError as http_err:
    print(f"HTTP error occurred: {http_err}")
    print(f"Response body: {response.text}")
except requests.exceptions.ConnectionError as conn_err:
    print(f"Connection error occurred: {conn_err}")
except requests.exceptions.Timeout as timeout_err:
    print(f"Timeout error occurred: {timeout_err}")
except requests.exceptions.RequestException as req_err:
    print(f"An unexpected error occurred: {req_err}")
except json.JSONDecodeError:
    print(f"Failed to decode JSON from response: {response.text}")
สคริปต์นี้เป็นเพียงจุดเริ่มต้น ทีม DevOps สามารถปรับปรุงให้ดึงข้อมูลได้ละเอียดขึ้น, คำนวณเป็นบาทไทย, และเชื่อมต่อกับระบบแจ้งเตือนต่างๆ เช่น Slack, Line Notify หรือ Prometheus/Grafana เพื่อสร้าง Dashboard แสดงผลการใช้งานแบบ Real-time และตั้ง Alert Rule ได้

กลยุทธ์สำหรับนักพัฒนาและองค์กรไทยในการรับมือ
การปรับตัวเป็นสิ่งสำคัญ นักพัฒนาและองค์กรไทยสามารถใช้กลยุทธ์ดังต่อไปนี้เพื่อรับมือกับการเปลี่ยนแปลงนี้ และยังคงใช้ประโยชน์จาก AI ได้อย่างมีประสิทธิภาพ
1. ตรวจสอบและประเมินการใช้งานปัจจุบันอย่างละเอียด
ขั้นตอนแรกคือการทำความเข้าใจว่าปัจจุบันมีการใช้งาน OpenAI API มากน้อยเพียงใด และโมเดลใดถูกใช้งานบ่อยที่สุดในแต่ละส่วนของระบบ ลองใช้สคริปต์ตัวอย่างด้านบนหรือใช้เครื่องมือ Monitoring ที่มีอยู่ เพื่อรวบรวมข้อมูลการใช้งาน Token และค่าใช้จ่ายจริงในช่วง 1-2 เดือนที่ผ่านมา
2. เพิ่มประสิทธิภาพ Prompt Engineering
Prompt ที่ออกแบบมาไม่ดีอาจทำให้สิ้นเปลือง Token โดยไม่จำเป็น การเรียนรู้และปรับปรุง Prompt Engineering ให้มีประสิทธิภาพมากขึ้น สามารถลดจำนวน Token ที่ใช้ในการเรียก API ได้อย่างมาก ตัวอย่างเช่น การให้คำสั่งที่ชัดเจนและกระชับ, การใช้ Few-shot learning อย่างเหมาะสม, หรือการสรุปข้อมูลก่อนส่งให้ AI ประมวลผล
3. เลือกใช้โมเดลที่เหมาะสม
OpenAI มีโมเดลให้เลือกหลากหลาย เช่น GPT-3.5 Turbo ที่มีราคาถูกกว่า GPT-4 อย่างมาก หากงานนั้นๆ ไม่ได้ต้องการความซับซ้อนหรือความแม่นยำสูงเท่า GPT-4 การใช้ GPT-3.5 Turbo อาจเป็นทางเลือกที่คุ้มค่ากว่า เช่น การสร้าง Draft เอกสารเบื้องต้น, การสรุปข้อความสั้นๆ, หรือการสร้าง Test Data ทั่วไป
4. Implement Caching และ Rate Limiting
สำหรับคำขอ API ที่ให้ผลลัพธ์เหมือนเดิมหรือมีการเปลี่ยนแปลงน้อย การทำ Caching สามารถช่วยลดจำนวนการเรียก API จริงๆ ได้อย่างมาก นอกจากนี้ การใช้ Rate Limiting ทั้งฝั่ง Client-side และ/หรือ API Gateway จะช่วยป้องกันไม่ให้ระบบเรียก API ถี่เกินไปจนเกินขีดจำกัดที่ OpenAI กำหนดไว้โดยไม่ตั้งใจ
# ตัวอย่างการใช้ curl เพื่อทดสอบ Rate Limit
# หากเรียกถี่เกินไป จะได้รับ HTTP 429 Too Many Requests
for i in {1..20}; do
  curl -X POST https://api.openai.com/v1/chat/completions \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer YOUR_OPENAI_API_KEY" \
    -d '{
      "model": "gpt-3.5-turbo",
      "messages": [
        {"role": "user", "content": "Hello, world!"}
      ]
    }' &
done
5. พิจารณา Open-Source LLMs สำหรับบาง Use Case
หากต้นทุนกลายเป็นข้อจำกัดที่สำคัญ การพิจารณา Fine-tuning หรือ Deploy Open-Source LLMs เช่น Llama 2, Mistral, หรือ Falcon บน Infrastructure ของตนเอง อาจเป็นทางเลือกที่น่าสนใจสำหรับ Use Case ที่เฉพาะเจาะจง แม้จะต้องลงทุนในส่วนของ Hardware และ MLOps Setup แต่ในระยะยาวอาจประหยัดกว่าสำหรับปริมาณการใช้งานที่สูงมาก
6. วางแผนงบประมาณและ SLA สำหรับ AI
องค์กรควรเริ่มวางแผนงบประมาณสำหรับ AI โดยเฉพาะ และกำหนด Service Level Agreement (SLA) สำหรับแอปพลิเคชันที่ใช้ AI เพื่อตัดสินใจว่าควรลงทุนในแพ็กเกจ Pro Plan หรือไม่ ควรมีแผนรองรับหากมีการถึงขีดจำกัดการใช้งาน เช่น การเปลี่ยนไปใช้โมเดลอื่น, การแจ้งเตือนผู้ใช้งาน, หรือการปรับลดฟังก์ชันการทำงานที่ใช้ AI ชั่วคราว

ในการนำเทคโนโลยีหรือแนวปฏิบัตินี้ไปปรับใช้จริง ควรคำนึงถึง Security Hardening, Observability และการทดสอบแบบ Automated เสมอ เพื่อความเสถียรสูงสุดในระดับ Production
มุมมองสำหรับนักพัฒนาและองค์กรไทย
สำหรับนักพัฒนาไทย การเปลี่ยนแปลงนี้เป็นโอกาสอันดีที่จะฝึกฝนทักษะด้าน Prompt Engineering และการบริหารจัดการทรัพยากร AI ซึ่งจะเป็นทักษะที่สำคัญอย่างยิ่งในอนาคต การเป็นนักพัฒนาที่สามารถสร้างสรรค์โซลูชัน AI ที่มีประสิทธิภาพพร้อมกับควบคุมต้นทุนได้ จะเป็นที่ต้องการอย่างสูงในตลาด
สำหรับองค์กรไทย โดยเฉพาะ SME และ Startup ที่มีงบประมาณจำกัด การปรับตัวอย่างรวดเร็วและการบริหารจัดการการใช้งาน AI อย่างชาญฉลาดเป็นสิ่งจำเป็น การใช้ AI อย่างฟุ่มเฟือยอาจกลายเป็นภาระต้นทุนที่ไม่คาดคิด ในทางกลับกัน องค์กรขนาดใหญ่อาจมองว่า Pro Plan เป็นการลงทุนที่คุ้มค่าเพื่อรักษาความได้เปรียบในการแข่งขันและรับประกันความเสถียรของระบบที่ขับเคลื่อนด้วย AI
นอกจากนี้ การเปลี่ยนแปลงนี้อาจกระตุ้นให้เกิดการพิจารณาลงทุนในบุคลากร MLOps และ Data Scientists ที่มีความสามารถในการจัดการและ Optimize โมเดล AI ทั้งจากผู้ให้บริการภายนอกและโมเดล Open-Source ซึ่งจะนำไปสู่การสร้างขีดความสามารถด้าน AI ภายในองค์กรที่แข็งแกร่งขึ้นในระยะยาว
โดยรวมแล้ว การปรับแผนราคาของ OpenAI เป็นสัญญาณที่ชัดเจนว่าตลาด AI กำลังเข้าสู่ช่วงการเติบโตอย่างเป็นผู้ใหญ่ การใช้งาน AI จะไม่ฟรีหรือราคาถูกอีกต่อไป การบริหารจัดการต้นทุน AI จะกลายเป็นส่วนหนึ่งที่แยกไม่ออกจากการวางแผนและปฏิบัติงานของทีม DevOps และ MLOps ในอนาคต
ที่มา: วิเคราะห์และเรียบเรียงเพิ่มเติมจาก The New Stack