จากดาวพุธสู่โลกแห่งข้อมูล: บทเรียน AI/ML จากภารกิจ BepiColombo สู่การพัฒนาไทย
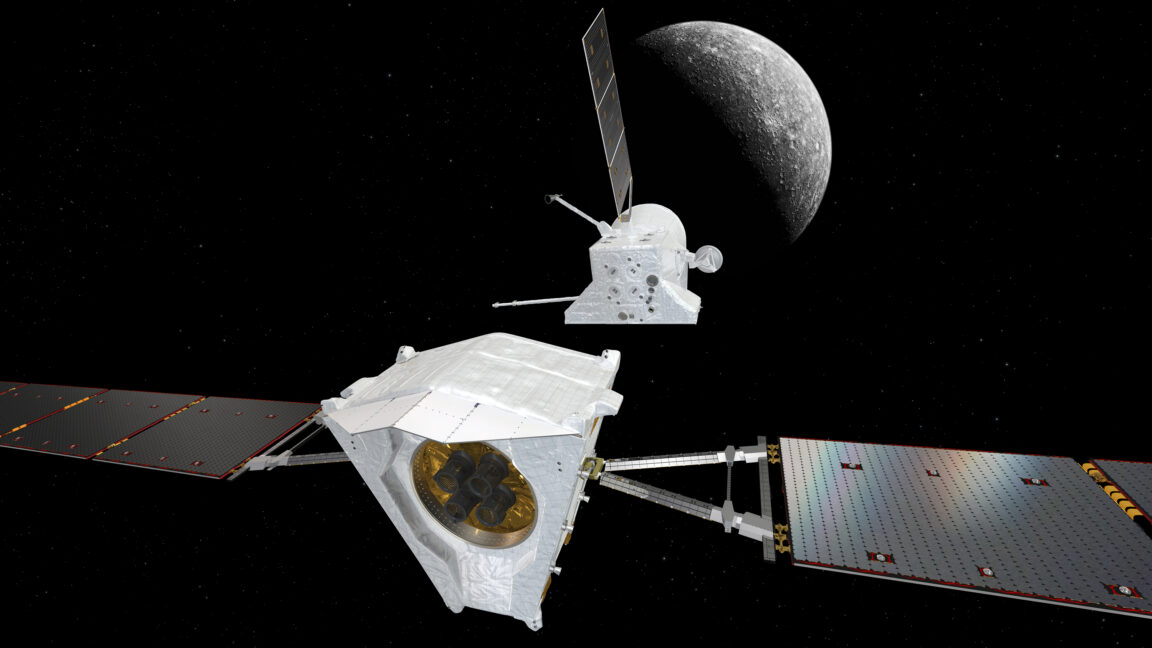
กว่าแปดปีของการเดินทางอันยาวนานและท้าทาย ภารกิจ BepiColombo ของยุโรปกำลังจะเข้าสู่โคจรสุดท้ายรอบดาวพุธ ดาวเคราะห์ที่ใกล้ดวงอาทิตย์ที่สุด การเดินทางนี้ไม่ใช่แค่ความสำเร็จทางวิศวกรรมอวกาศเท่านั้น แต่ยังเป็นสัญลักษณ์ของการแสวงหาความรู้และความเข้าใจในสิ่งที่ซับซ้อนและลึกลับที่สุดในจักรวาล เช่นเดียวกับที่นักวิทยาศาสตร์ต้องการ “เรียนรู้เกี่ยวกับต้นกำเนิดของดาวเคราะห์ดวงนี้และวิวัฒนาการของมัน” หลักการเดียวกันนี้ได้สะท้อนอยู่ในโลกของเทคโนโลยี โดยเฉพาะอย่างยิ่งในสาขา AI และ Machine Learning ที่มุ่งมั่นจะ “ถอดรหัส” ความลับจากข้อมูลมหาศาล เพื่อทำความเข้าใจระบบที่ซับซ้อนรอบตัวเรา ไม่ว่าจะเป็นพฤติกรรมผู้บริโภค การเปลี่ยนแปลงสภาพภูมิอากาศ หรือแม้กระทั่งการทำงานของเซลล์ในร่างกายมนุษย์ บทความนี้จะพาคุณเจาะลึกถึงแก่นแท้ของภารกิจ BepiColombo และนำหลักคิด เทคโนโลยี และความท้าทายที่คล้ายคลึงกัน มาวิเคราะห์เชื่อมโยงกับโลกของ AI และ Machine Learning ที่นักพัฒนาและองค์กรไทยกำลังเผชิญ เพื่อสร้างแรงบันดาลใจและแนวทางในการพัฒนาโซลูชันอัจฉริยะที่แข็งแกร่งและยั่งยืน การเดินทาง 8 ปีสู่ดาวพุธ: บทเรียนจากความมุ่งมั่นและข้อมูลมหาศาล ภารกิจ BepiColombo คือความร่วมมือระหว่าง European Space Agency (ESA) และ Japan Aerospace Exploration Agency (JAXA) ที่ส่งยานอวกาศสองลำ ได้แก่ Mercury Planetary … Read more
ยุคแห่งความคลุมเครือ: ทำไมนักตรวจจับ AI ถึงยากกว่าแค่ ‘จริงหรือปลอม’

โลกดิจิทัลที่เราพึ่งพามานานกำลังเผชิญกับวิกฤตความน่าเชื่อถือครั้งใหญ่ ไม่ใช่แค่เพราะฟีดโซเชียลมีเดียเต็มไปด้วยเนื้อหาที่ AI สร้างขึ้นแบบลวก ๆ อีกต่อไป แต่เนื้อหาที่สร้างโดย AI ไม่ว่าจะเป็นข้อความ รูปภาพ หรือแม้แต่วิดีโอ กำลังแทรกซึมเข้าสู่แก่นกลางของกิจกรรมสำคัญต่าง ๆ ตั้งแต่การสมัครงาน รีวิวสินค้า ไปจนถึงการเคลมประกัน สิ่งนี้ทำให้ทั้งแพลตฟอร์มและผู้ใช้งานต่างต้องดิ้นรนเพื่อแยกแยะว่าอะไรคือ “ของจริง” และอะไรคือ “ของปลอม” ซึ่ง Max Spero จาก Pangram ได้ชี้ให้เห็นอย่างชัดเจนว่า การตรวจจับ AI นั้นซับซ้อนกว่าการตัดสินใจแค่ “จริงหรือปลอม” อย่างที่เราเคยเข้าใจ ในฐานะนักพัฒนาและสาย IT ไทย เราจำเป็นต้องทำความเข้าใจถึงความซับซ้อนที่แท้จริงเบื้องหลังการตรวจจับ AI เพื่อเตรียมรับมือกับภูมิทัศน์ที่เปลี่ยนแปลงไปนี้ ไม่ว่าจะเป็นการสร้างเครื่องมือ การวางนโยบาย หรือแม้แต่การปรับใช้เทคโนโลยี AI อย่างมีจริยธรรม ภูมิทัศน์ของความน่าเชื่อถือดิจิทัลที่เปลี่ยนแปลงไป เมื่อไม่กี่ปีที่ผ่านมา AI ที่สร้างเนื้อหาอาจจะยังดูหยาบและสามารถแยกแยะได้ง่าย แต่ด้วยความก้าวหน้าอย่างรวดเร็วของ Large Language Models (LLMs) และ Generative Adversarial Networks … Read more

ปฏิวัติกล่องค้นหา: Google Search พลิกโฉม 25 ปี สู่ประตูบานใหม่แห่งยุค AI Multimodal

ตลอดระยะเวลากว่า 25 ปีที่ผ่านมา “กล่องค้นหา” ของ Google ได้กลายเป็นสัญลักษณ์ที่คุ้นเคยที่สุดอย่างหนึ่งในการประมวลผลข้อมูลดิจิทัล สี่เหลี่ยมผืนผ้าสีขาวเรียบง่าย เคอร์เซอร์กระพริบ และคำไม่กี่คำที่พิมพ์ลงไป เพื่อนำทางเราไปสู่ “รายการลิงก์สีน้ำเงิน” อันไร้ขีดจำกัด แต่เมื่อไม่นานมานี้ Google ได้ประกาศการเปลี่ยนแปลงครั้งใหญ่ที่สุดในประวัติศาสตร์ของผลิตภัณฑ์เรือธงนี้ ซึ่งไม่ใช่แค่การปรับปรุงหน้าตา แต่เป็นการพลิกโฉมปรัชญาการทำงานโดยสิ้นเชิง สัญญาณที่ชัดเจนที่สุดว่าอนาคตของ Google Search ไม่ใช่แค่ที่สำหรับพิมพ์ Keyword แต่เป็นอินเทอร์เฟซที่เราสามารถสนทนาแบบเปิดกว้างและหลากหลายรูปแบบ (Multimodal) กับระบบ AI อันทรงพลัง การประกาศที่งาน Google I/O สั่นสะเทือนวงการเทคโนโลยี พร้อมกับการเปิดตัว Gemini รุ่นใหม่, Spark AI agent ส่วนบุคคล, รถเข็นช้อปปิ้งอัจฉริยะ และแพลตฟอร์มสำหรับนักพัฒนาที่ได้รับการปรับปรุงใหม่ แต่สิ่งที่ Liz Reid, รองประธานและหัวหน้าฝ่าย Search ของ Google, เรียกว่า “การอัปเกรดครั้งยิ่งใหญ่ที่สุดสำหรับกล่องค้นหาอันเป็นเอกลักษณ์ของเรานับตั้งแต่เปิดตัวเมื่อ 25 ปีก่อน” นั้น อาจกลายเป็นความเคลื่อนไหวที่สำคัญที่สุดและมีนัยยะต่ออนาคตของอินเทอร์เน็ตมากกว่าที่เราคิด จาก … Read more

เริ่มต้น Machine Learning ด้วย Python: scikit-learn สำหรับมือใหม่

ก้าวแรกสู่โลก Machine Learning ที่ไม่ซับซ้อน ในยุคที่ข้อมูลมีบทบาทสำคัญต่อทุกภาคส่วน “Machine Learning” (ML) หรือ “การเรียนรู้ของเครื่อง” ได้กลายเป็นหนึ่งในเทคโนโลยีที่ทรงพลังและน่าตื่นเต้นที่สุด ไม่ว่าจะเป็นการแนะนำสินค้าที่คุณอาจชอบบนแพลตฟอร์มออนไลน์, ระบบจดจำใบหน้าในสมาร์ทโฟน, ไปจนถึงการวินิจฉัยโรคทางการแพทย์ ทั้งหมดนี้ล้วนขับเคลื่อนด้วย ML หากคุณเป็นคนหนึ่งที่สนใจอยากจะเริ่มต้นสำรวจโลกอันกว้างใหญ่นี้ แต่ไม่รู้จะเริ่มจากตรงไหน บทความนี้จะพาคุณไปทำความเข้าใจพื้นฐานและเริ่มต้นใช้งานไลบรารีที่ได้รับความนิยมสูงสุดอย่าง scikit-learn ด้วยภาษา Python ที่เข้าใจง่ายและเป็นมิตรกับมือใหม่ Python เป็นภาษาโปรแกรมที่ได้รับความนิยมอย่างสูงในหมู่นักวิทยาศาสตร์ข้อมูลและนักพัฒนา ML ด้วยโครงสร้างที่อ่านง่าย มีไลบรารีสนับสนุนมากมาย และชุมชนขนาดใหญ่ที่พร้อมให้ความช่วยเหลือ scikit-learn คือหนึ่งในไลบรารีหลักที่ทำให้การสร้างโมเดล ML เป็นเรื่องง่ายดดาย เราจะมาดูกันว่าทำไม scikit-learn จึงเป็นเครื่องมือที่คุณควรมีติดตัวและจะเริ่มต้นใช้งานมันได้อย่างไร ภาพประกอบ: ภาพจำลองการทำงานของ Generative AI ในยุคปัจจุบัน Machine Learning คืออะไร? ทำไมต้อง Python? Machine Learning คือแขนงหนึ่งของปัญญาประดิษฐ์ (AI) ที่มุ่งเน้นการพัฒนาระบบที่สามารถ “เรียนรู้” จากข้อมูลได้โดยไม่ต้องถูกตั้งโปรแกรมอย่างชัดเจน (explicitly programmed) … Read more

AI Agent Architecture: ออกแบบ AI ที่ทำงานอัตโนมัติอย่างชาญฉลาด

ในยุคที่ปัญญาประดิษฐ์ก้าวหน้าอย่างก้าวกระโดด โดยเฉพาะอย่างยิ่ง Large Language Models (LLMs) ที่แสดงความสามารถในการทำความเข้าใจและสร้างภาษาได้อย่างน่าทึ่ง เราได้เห็นแอปพลิเคชัน AI ที่หลากหลาย ตั้งแต่ Chatbot อัจฉริยะไปจนถึงเครื่องมือช่วยเขียนโค้ด อย่างไรก็ตาม โมเดลเหล่านี้มักจะทำงานแบบ “ปฏิกิริยา” (reactive) กล่าวคือตอบสนองต่อคำสั่งหรือ Prompt ที่ได้รับมาโดยตรง ซึ่งจำกัดความสามารถในการทำงานที่ซับซ้อนต่อเนื่อง หรือการเรียนรู้และปรับตัวในระยะยาว นี่คือจุดที่ “AI Agent” เข้ามามีบทบาทสำคัญ AI Agent ไม่ใช่แค่โมเดล AI ที่ตอบ Prompt เท่านั้น แต่เป็นระบบ AI ที่มีความสามารถในการรับรู้สภาพแวดล้อม ตัดสินใจ วางแผน ลงมือทำ และเรียนรู้ เพื่อบรรลุเป้าหมายที่กำหนดไว้ได้อย่างอิสระและอัตโนมัติ การสร้าง AI Agent ที่มีประสิทธิภาพจึงไม่ใช่แค่การเลือกโมเดล AI ที่ดีที่สุด แต่คือการออกแบบสถาปัตยกรรมที่แข็งแกร่งและยืดหยุ่น บทความนี้จะเจาะลึกถึงหลักการและองค์ประกอบสำคัญของ AI Agent Architecture เพื่อให้คุณเข้าใจและสามารถออกแบบ AI ที่ทำงานอัตโนมัติได้อย่างชาญฉลาด … Read more

AI กับลิขสิทธิ์: ปมซับซ้อนที่นักพัฒนาและองค์กรไทยต้องถอดรหัส

ในโลกที่เทคโนโลยีปัญญาประดิษฐ์ (AI) โดยเฉพาะโมเดลภาษาขนาดใหญ่ (Large Language Models – LLMs) กำลังขับเคลื่อนนวัตกรรมและพลิกโฉมการทำงานไปอย่างรวดเร็ว มีประเด็นสำคัญที่ถูกหยิบยกขึ้นมาพูดถึงอย่างกว้างขวาง นั่นคือ “AI เรียนรู้จากอะไร?” และ “การนำข้อมูลที่มีลิขสิทธิ์มาฝึก AI นั้นถูกต้องตามกฎหมายหรือไม่?” คำถามเหล่านี้ไม่ได้เป็นเพียงประเด็นทางกฎหมายสำหรับนักกฎหมายเท่านั้น แต่ยังเป็นความท้าทายเชิงเทคนิค จริยธรรม และกลยุทธ์สำหรับนักพัฒนาและองค์กร IT ในประเทศไทยด้วยเช่นกัน บทความจาก TechCrunch AI ที่ตั้งคำถามว่า “Is it legal to train AI models on copyrighted books? It’s complicated” ได้ตอกย้ำถึงความซับซ้อนนี้ โดยชี้ให้เห็นว่าผู้สร้างสรรค์ผลงานจำนวนมากโดยเฉพาะนักเขียน อาจตกเป็นส่วนหนึ่งของการพัฒนาเครื่องมือ AI ที่อาจคุกคามอาชีพของพวกเขาเอง โดยที่พวกเขาไม่รู้ตัวหรือไม่ได้ให้ความยินยอม นี่คือจุดเริ่มต้นของบทวิเคราะห์เชิงลึก ที่จะพาเราไปสำรวจมิติทางเทคนิค กฎหมาย และจริยธรรม พร้อมทั้งฉายภาพบริบทที่เกี่ยวข้องกับประเทศไทย ปมซับซ้อนของ AI, ข้อมูล และลิขสิทธิ์ หัวใจสำคัญของการพัฒนา … Read more

Anthropic Cowork: เมื่อ AI Agent ก้าวข้ามโค้ด สู่การเป็นผู้ช่วยส่วนตัวในทุกไฟล์งานของคุณ

ในโลกที่ AI พัฒนาไปอย่างก้าวกระโดด เราได้เห็นโมเดลภาษาขนาดใหญ่ (LLMs) ที่สามารถสร้างสรรค์บทกวี เขียนโค้ด หรือตอบคำถามได้อย่างน่าทึ่ง แต่คำถามสำคัญที่ยังคงอยู่คือ: AI เหล่านี้จะสามารถก้าวข้ามจาก “เครื่องมืออัจฉริยะ” ไปสู่ “ผู้ช่วยส่วนตัว” ที่สามารถจัดการงานซับซ้อนในชีวิตประจำวันของเราได้อย่างไร? Anthropic บริษัทผู้พัฒนา Claude AI ได้จุดประกายคำตอบนั้นด้วยการเปิดตัว Cowork ความสามารถใหม่ล่าสุดที่เปลี่ยน Claude ให้กลายเป็น Desktop Agent ที่ทำงานร่วมกับไฟล์บนเครื่องของคุณได้อย่างชาญฉลาด โดยไม่ต้องอาศัยความรู้ด้านการเขียนโค้ดแม้แต่น้อย การมาถึงของ Cowork ไม่ใช่แค่การเพิ่มฟีเจอร์ใหม่ให้กับ Claude เท่านั้น แต่เป็นการส่งสัญญาณที่ชัดเจนว่ายุคของ AI Agent ที่เข้าถึงได้สำหรับผู้ใช้งานทั่วไปได้เริ่มต้นขึ้นแล้ว มันไม่ได้เป็นเพียงแค่คู่แข่งของ OpenAI หรือ Google ในสนาม AI เชิงสนทนา แต่ยังเป็นการท้าทาย Microsoft Copilot ในตลาดเครื่องมือเพิ่มประสิทธิภาพการทำงานด้วย AI ที่กำลังเติบโตอย่างรวดเร็ว สำหรับนักพัฒนาและผู้บริหาร IT ในไทย นี่คือหมุดหมายสำคัญที่ต้องจับตา เพราะมันอาจเปลี่ยนวิธีการทำงานของเราไปตลอดกาล … Read more

ปลดล็อกขุมทรัพย์รายได้ที่ซ่อนอยู่: เจาะลึก Market Models และ AI เพื่อการกำหนดราคายุคใหม่ในไทย

ในโลกธุรกิจที่การแข่งขันดุเดือดขึ้นทุกวัน การกำหนดราคาที่เหมาะสมไม่ใช่แค่ศิลปะอีกต่อไป แต่กลายเป็นวิทยาศาสตร์ที่ต้องอาศัยข้อมูลเชิงลึกและเทคโนโลยีขั้นสูง องค์กรจำนวนมากยังคงติดอยู่กับการกำหนดราคาแบบเดิมๆ ที่อาศัยกฎเกณฑ์ตายตัวหรือการคาดการณ์จากประสบการณ์ ซึ่งมักทำให้พลาดโอกาสในการสร้างรายได้ที่ซ่อนอยู่ บทความต้นฉบับจาก MIT Tech Review AI ชี้ให้เห็นถึงศักยภาพของ “Market Models” ในการพลิกโฉมการทำความเข้าใจและตอบสนองต่อพลวัตของตลาด โดยเฉพาะในอุตสาหกรรมที่ซับซ้อนอย่างสายการบิน ที่ต้องบริหารจัดการตัวแปรนับร้อยนับพันเพื่อกำหนดราคาตั๋วในแต่ละเส้นทางที่ซับซ้อน สำหรับนักพัฒนาและสาย IT ในประเทศไทย การทำความเข้าใจ Market Models และการนำ AI/Machine Learning มาประยุกต์ใช้ คือกุญแจสำคัญที่จะช่วยให้องค์กรไทยก้าวข้ามขีดจำกัดเดิมๆ สร้างความได้เปรียบทางการแข่งขัน และปลดล็อกแหล่งรายได้ใหม่ๆ ที่ไม่เคยถูกค้นพบมาก่อน Market Models คืออะไร และทำไมถึงสำคัญกับธุรกิจไทย? Market Models คือระบบจำลองทางคณิตศาสตร์และอัลกอริทึมที่ออกแบบมาเพื่อทำความเข้าใจ คาดการณ์ และตอบสนองต่อพฤติกรรมของตลาด ภายใต้เงื่อนไขและตัวแปรที่หลากหลาย ไม่ใช่แค่การกำหนดราคาตามต้นทุนบวกกำไร หรือการตั้งราคาตามคู่แข่งอีกต่อไป แต่เป็นการสร้างโมเดลที่สามารถซึมซับและเรียนรู้จากข้อมูลจำนวนมหาศาล เพื่อทำนายอุปสงค์ อุปทาน ความยืดหยุ่นของราคา (Price Elasticity) และผลกระทบของการเปลี่ยนแปลงราคาต่อพฤติกรรมผู้บริโภค ความสำคัญของ Market Models ในบริบทของประเทศไทย: 1. … Read more

RAG (Retrieval Augmented Generation): สร้าง AI ที่รู้จักเอกสารของคุณ

ในยุคที่โมเดลภาษาขนาดใหญ่ (Large Language Models – LLMs) อย่าง GPT-4 หรือ Llama กำลังปฏิวัติโลกเทคโนโลยี ความสามารถอันน่าทึ่งในการสร้างสรรค์ข้อความ ตอบคำถาม และโต้ตอบกับมนุษย์ได้อย่างเป็นธรรมชาติ ได้เปิดประตูสู่ความเป็นไปได้ใหม่ๆ มากมาย อย่างไรก็ตาม LLMs ก็ยังคงมีข้อจำกัดบางประการที่ทำให้การนำไปใช้งานจริงในบริบทเฉพาะมีความท้าทาย ไม่ว่าจะเป็นปัญหา “Halucination” หรือการสร้างข้อมูลที่ดูน่าเชื่อถือแต่ไม่เป็นความจริง การขาดความรู้เฉพาะทางในโดเมนที่โมเดลไม่เคยถูกฝึกมาก่อน หรือข้อมูลที่ล้าสมัยเนื่องจากโมเดลถูกหยุดฝึก ณ จุดเวลาหนึ่งๆ นี่คือจุดที่เทคโนโลยีอย่าง **RAG (Retrieval Augmented Generation)** ก้าวเข้ามาเพื่อเติมเต็มช่องว่างเหล่านี้ RAG เป็นแนวคิดที่ผสานรวมความสามารถในการดึงข้อมูลจากแหล่งความรู้ภายนอกเข้ากับการสร้างข้อความของ LLMs ทำให้ AI สามารถเข้าถึงข้อมูลที่เป็นปัจจุบัน ถูกต้อง และเฉพาะเจาะจงกับบริบทของคุณได้ราวกับมีห้องสมุดส่วนตัวอยู่ในมือ บทความนี้จะพาคุณไปเจาะลึกถึงหลักการทำงาน ประโยชน์ และวิธีนำ RAG ไปใช้เพื่อสร้าง AI ที่ “รู้จักเอกสารของคุณ” อย่างแท้จริง RAG คืออะไร? RAG ย่อมาจาก Retrieval Augmented … Read more

Vector Database คืออะไร: Pinecone, Chroma, Weaviate เปรียบเทียบ

ในยุคที่ปัญญาประดิษฐ์ (AI) โดยเฉพาะอย่างยิ่ง Large Language Models (LLMs) และ Generative AI ได้เข้ามาเปลี่ยนแปลงภูมิทัศน์ของเทคโนโลยีอย่างรวดเร็ว หนึ่งในเทคโนโลยีเบื้องหลังที่สำคัญและถูกพูดถึงอย่างมากคือ “Vector Database” มันคือหัวใจสำคัญที่ช่วยให้ AI สามารถเข้าใจบริบท ความหมาย และความสัมพันธ์ของข้อมูลได้อย่างลึกซึ้งกว่าฐานข้อมูลแบบดั้งเดิม บทความนี้จะพาคุณไปทำความเข้าใจว่า Vector Database คืออะไร ทำไมมันถึงจำเป็น และเราจะเปรียบเทียบผู้เล่นหลักในตลาดอย่าง Pinecone, Chroma และ Weaviate เพื่อช่วยให้คุณตัดสินใจเลือกเครื่องมือที่เหมาะสมกับโครงการของคุณ Vector Database คืออะไร? โดยพื้นฐานแล้ว Vector Database คือฐานข้อมูลประเภทหนึ่งที่ออกแบบมาเพื่อจัดเก็บ จัดการ และค้นหาข้อมูลในรูปแบบของ “เวกเตอร์” (Vectors) หรือชุดตัวเลขที่แสดงถึงคุณสมบัติของข้อมูลในพื้นที่หลายมิติ (high-dimensional space) ข้อมูลเหล่านี้ถูกสร้างขึ้นผ่านกระบวนการที่เรียกว่า “Vector Embedding” ซึ่งใช้โมเดล Machine Learning ในการแปลงข้อมูลหลากหลายรูปแบบ ไม่ว่าจะเป็นข้อความ รูปภาพ เสียง หรือวิดีโอ … Read more