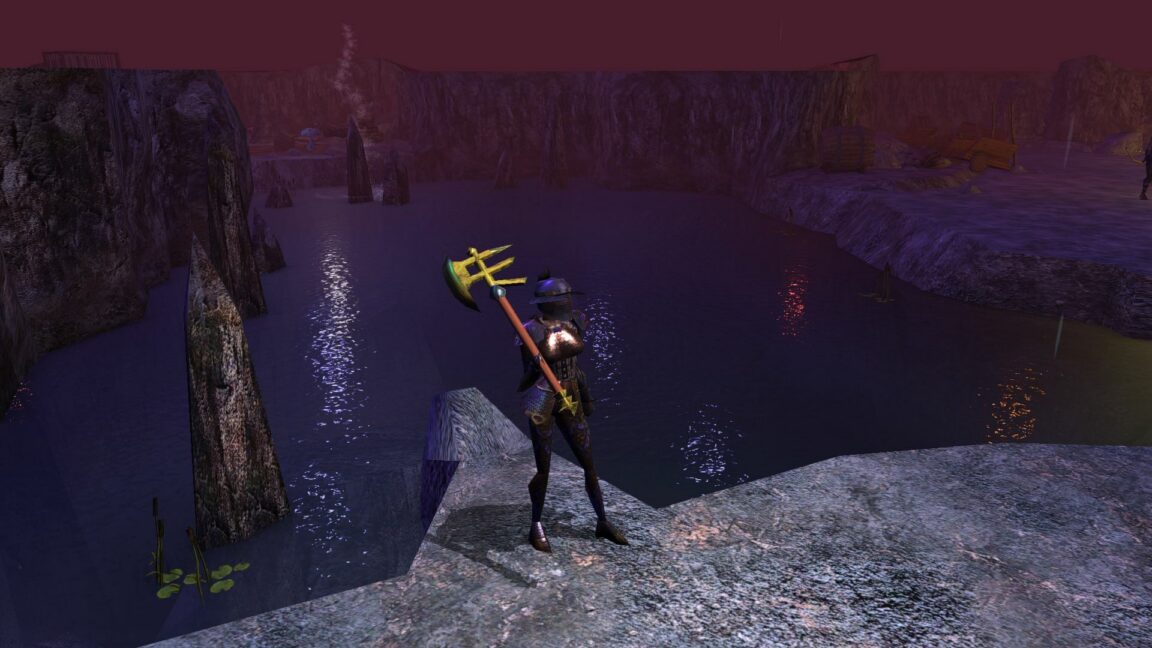
ในโลกของเทคโนโลยีที่หมุนเร็ว การแสวงหานวัตกรรมใหม่ๆ ดูเหมือนจะเป็นหัวใจสำคัญของการอยู่รอด ทว่าบางครั้งบทเรียนอันล้ำค่ากลับซ่อนอยู่ในสิ่งที่ดูเหมือนจะล้าสมัยไปแล้ว เช่นเดียวกับกรณีของเกม Role-Playing Game (RPG) ระดับตำนานอย่าง BioWare’s Neverwinter Nights (NWN) ที่แม้จะเปิดตัวมาตั้งแต่ปี 2002 แต่ยังคงมีผู้เล่นนับพันคนใช้งานอย่างต่อเนื่อง บทความจาก Ars Technica ชี้ให้เห็นว่า “โหมดเล่นคนเดียวของเกมนี้ก็แค่พอใช้ได้ แต่สำหรับผู้เล่นแล้ว นั่นไม่ใช่ประเด็น” สิ่งที่ทำให้ NWN ยังคงมีชีวิตอยู่ได้คือ “แพลตฟอร์ม” ที่เอื้อต่อการสร้างสรรค์, การปรับแต่ง, และชุมชนผู้เล่นที่เข้มแข็ง นี่คือบทเรียนสำคัญที่เราสามารถนำมาปรับใช้กับการพัฒนา AI และ Machine Learning ในบริบทของนักพัฒนาและองค์กรไทยได้เป็นอย่างดี โดยเฉพาะอย่างยิ่งในยุคที่โมเดล AI ใหม่ๆ เกิดขึ้นแทบทุกวัน แต่การนำไปใช้งานจริงให้เกิดความยั่งยืนนั้น กลับเป็นความท้าทายที่แท้จริง
แก่นแท้ของความยั่งยืน: บทเรียนจากโลกเกมสู่ AI/ML
Neverwinter Nights ไม่ได้โดดเด่นด้วยกราฟิกสุดล้ำหรือเนื้อเรื่องหลักที่พลิกโลก แต่สิ่งที่ทำให้มันเป็นอมตะคือ “Aurora Toolset” ซึ่งเป็นชุดเครื่องมือที่มาพร้อมกับเกม ที่เปิดโอกาสให้ผู้เล่นสามารถสร้างโลก, เนื้อเรื่อง, ตัวละคร, ไอเท็ม, และแม้กระทั่งระบบเกมเพลย์ของตัวเองได้เกือบจะไร้ขีดจำกัด เครื่องมือเหล่านี้ประกอบกับระบบ Multiplayer ที่เอื้อให้ผู้เล่นสามารถแบ่งปันและเล่น “โมดูล” หรือเนื้อหาที่สร้างขึ้นเองร่วมกัน ทำให้เกิดระบบนิเวศ (Ecosystem) ที่ขับเคลื่อนด้วยชุมชนอย่างแท้จริง ผู้เล่นไม่ได้แค่บริโภคเกม แต่เป็นผู้สร้างและผู้มีส่วนร่วมในการขยายจักรวาลของเกมออกไปอย่างไม่รู้จบ
ในโลกของ AI และ Machine Learning เรามักจะตื่นเต้นกับโมเดลใหม่ๆ ที่ทำลายสถิติ (state-of-the-art) หรืออัลกอริทึมที่ชาญฉลาด แต่บทเรียนจาก NWN สอนเราว่า “โมเดลเดี่ยว” หรือ “ประสิทธิภาพเริ่มต้น” อาจไม่ใช่ปัจจัยเดียวที่กำหนดความสำเร็จและความยั่งยืนในระยะยาว สิ่งที่สำคัญไม่แพ้กันคือ “แพลตฟอร์ม” หรือ “Ecosystem” ที่อยู่รอบๆ โมเดลนั้นๆ ซึ่งรวมถึงเฟรมเวิร์ก, ไลบรารี, เครื่องมือ, ความสามารถในการปรับแต่ง, และที่สำคัญที่สุดคือชุมชนนักพัฒนาที่พร้อมจะสร้างสรรค์และต่อยอด

เมื่อแพลตฟอร์มสำคัญกว่าโมเดลเดี่ยว: พลังของ Ecosystem ใน AI
Frameworks และ Libraries: หัวใจของการต่อยอด
ในโลก AI เฟรมเวิร์กอย่าง TensorFlow, PyTorch หรือไลบรารีอย่าง Scikit-learn เปรียบเสมือน Aurora Toolset ของ NWN พวกมันไม่ได้แค่เป็นเครื่องมือสำหรับสร้างโมเดล แต่เป็นโครงสร้างพื้นฐานที่มอบความยืดหยุ่นและพลังในการปรับแต่งและขยายขีดความสามารถ ไม่ว่าจะเป็นการสร้าง Custom Layers, การเชื่อมต่อกับ Data Pipelines ที่ซับซ้อน หรือการปรับใช้โมเดลในสภาพแวดล้อมที่หลากหลาย
ความสำเร็จของเฟรมเวิร์กเหล่านี้ไม่ได้มาจากประสิทธิภาพของอัลกอริทึมพื้นฐานเพียงอย่างเดียว แต่มาจาก API ที่ใช้งานง่าย, เอกสารประกอบที่ครบถ้วน, และความสามารถในการรวมเข้ากับเครื่องมืออื่นๆ ในระบบนิเวศ ตัวอย่างเช่น การโหลดโมเดล Pre-trained แล้วปรับแต่งส่วนหัว (Classification Head) เพื่อให้เข้ากับชุดข้อมูลเฉพาะของเรา ซึ่งเป็นแนวทางปฏิบัติที่แพร่หลายและมีประสิทธิภาพสูง:
import torch
from transformers import AutoModelForSequenceClassification, AutoTokenizer

# เลือกโมเดลพื้นฐานที่ผ่านการ Pre-train มาแล้ว (เช่น Thai BERT จาก Hugging Face)
model_name = "wangchanberta-base-att-spm-aiforthai"
tokenizer = AutoTokenizer.from_pretrained(model_name)

# โหลดโมเดลสำหรับงานจำแนกประเภท (เช่น 2 ประเภท)
# โดย default จะมี Classification Head มาให้แล้ว
model = AutoModelForSequenceClassification.from_pretrained(model_name, num_labels=2)

# หากต้องการปรับแต่ง Classification Head ด้วยตัวเอง
# สามารถเข้าถึงและแทนที่ส่วนนี้ได้ (ในบางกรณีอาจต้องสร้างโมเดลใหม่ทั้งหมด)
# ตัวอย่าง: สมมติว่าต้องการเปลี่ยนเป็น Linear layer ที่มีจำนวน output ต่างกัน
# model.classifier = torch.nn.Linear(model.config.hidden_size, num_new_labels)
# print(f"โมเดลเดิมมี Classification Head เป็น: {model.classifier}")
# model.classifier = torch.nn.Sequential(
#     torch.nn.Dropout(model.config.classifier_dropout),
#     torch.nn.Linear(model.config.hidden_size, 256),
#     torch.nn.ReLU(),
#     torch.nn.Linear(256, 3) # สมมติว่ามี 3 classes
# )
# print(f"Classification Head ใหม่: {model.classifier}")

# เตรียมข้อมูลสำหรับ Fine-tuning (ตัวอย่างข้อความภาษาไทย)
texts = ["นี่คือตัวอย่างข้อความเชิงบวก", "นี่คือตัวอย่างข้อความเชิงลบ"]
inputs = tokenizer(texts, padding=True, truncation=True, return_tensors="pt")
labels = torch.tensor([1, 0]) # ตัวอย่าง labels

print(f"โมเดล {model_name} ถูกโหลดและพร้อมสำหรับการ Fine-tuning")
print(f"รูปร่างของ Input IDs: {inputs['input_ids'].shape}")
print(f"จำนวนคลาสสำหรับการจำแนก: {model.num_labels}")
โค้ดข้างต้นแสดงให้เห็นถึงความยืดหยุ่นในการนำโมเดล Pre-trained มาใช้งานและปรับแต่ง ซึ่งเป็นหัวใจสำคัญของการต่อยอดใน AI
Open-Source และ Community: แรงขับเคลื่อนนวัตกรรม
Hugging Face Hub คือตัวอย่างที่ชัดเจนของ “ชุมชน” ในโลก AI ที่ทำหน้าที่คล้ายกับฟอรัมและเว็บไซต์แบ่งปันโมดูลของ NWN ที่นี่นักพัฒนาสามารถค้นหา, แบ่งปัน, และร่วมมือกันพัฒนาโมเดล, Datasets, และ Demos ได้อย่างอิสระ ทำให้การเข้าถึงเทคโนโลยี AI ที่ซับซ้อนเป็นเรื่องง่ายขึ้นมาก การที่โมเดลภาษาขนาดใหญ่ (LLMs) และโมเดลวิสัยทัศน์ (Vision Models) จำนวนมากถูกเปิดเป็น Open-Source ทำให้การทดลองและสร้างสรรค์สิ่งใหม่ๆ เกิดขึ้นได้อย่างรวดเร็ว ไม่ว่าจะเป็นการปรับแต่งโมเดลให้เข้าใจภาษาไทย หรือนำไปประยุกต์ใช้กับข้อมูลเฉพาะทางในอุตสาหกรรมต่างๆ

การปรับแต่งและการต่อยอด: AI ที่ “หายใจ” ได้
Transfer Learning และ Fine-tuning: ยุทธศาสตร์หลักของนักพัฒนาไทย
การสร้างโมเดล AI จากศูนย์ (From Scratch) โดยเฉพาะอย่างยิ่งโมเดลภาษาขนาดใหญ่หรือโมเดลที่ต้องการข้อมูลมหาศาล เป็นเรื่องที่ต้องใช้ทรัพยากรด้านคอมพิวเตอร์และเวลาสูงมาก ซึ่งอาจเกินกำลังของนักพัฒนาหรือองค์กรส่วนใหญ่ในไทย ด้วยเหตุนี้ “Transfer Learning” และ “Fine-tuning” จึงกลายเป็นยุทธศาสตร์หลัก ที่ช่วยให้เราสามารถนำความรู้ที่โมเดล Pre-trained เรียนรู้จากข้อมูลขนาดใหญ่และหลากหลาย มาปรับใช้กับงานเฉพาะทางของเราได้ด้วยชุดข้อมูลที่มีขนาดเล็กกว่าและใช้ทรัพยากรน้อยกว่ามาก
| คุณสมบัติ | การสร้าง AI จากศูนย์ (Scratch) | การใช้โมเดลสำเร็จรูปและ Ecosystem (Fine-tuning) |
|---|---|---|
| เวลาพัฒนาเริ่มต้น | สูงมาก (ต้องออกแบบ, รวบรวมข้อมูล, ฝึก) | ต่ำกว่ามาก (เน้นการปรับแต่งและประยุกต์) |
| ทรัพยากร (Compute) | สูงมาก (ในการฝึกโมเดลขนาดใหญ่) | ต่ำกว่า (ใช้ในการ Fine-tuning และ Inference) |
| ความเชี่ยวชาญ | สูง (ด้าน ML Algorithm, Data Engineering, Research) | ปานกลาง (ด้านการปรับแต่ง, API, MLOps) |
| ความยืดหยุ่น | สูงสุด (ควบคุมทุกอย่างตั้งแต่ระดับพื้นฐาน) | สูง (ปรับแต่งได้มากในระดับ Application) |
| การเข้าถึงข้อมูล | ต้องมีข้อมูลขนาดใหญ่และคุณภาพสูงมาก | ใช้ข้อมูลเฉพาะงานขนาดเล็กถึงปานกลางได้ดี |
| ความเร็วในการนำไปใช้ | ช้า (ต้องผ่านกระบวนการวิจัยและพัฒนา) | เร็ว (เหมาะสำหรับการสร้าง MVP และ POC) |
| ตัวอย่าง | วิจัยโมเดล LLM ใหม่, พัฒนาอัลกอริทึมพื้นฐาน | Chatbot สนับสนุนภาษาไทย, ระบบแนะนำสินค้า, การจำแนกภาพสินค้า |
| เหมาะสำหรับ | งานวิจัยเชิงลึก, โมเดลเฉพาะทางที่ไม่เคยมีมาก่อน | การนำ AI ไปใช้จริงในภาคธุรกิจ, การพัฒนาโซลูชันอย่างรวดเร็ว |
MLOps และ Tooling: สร้างวงจรชีวิต AI ที่แข็งแกร่ง
การพัฒนาโมเดล AI เป็นเพียงส่วนหนึ่งของสมการทั้งหมด การนำโมเดลไปใช้งานจริง (Deployment), การติดตามประสิทธิภาพ (Monitoring), การบำรุงรักษา (Maintenance), และการอัปเดต (Updating) คือสิ่งที่กำหนดความสำเร็จในระยะยาว และนี่คือจุดที่ MLOps (Machine Learning Operations) และชุดเครื่องมือต่างๆ เข้ามามีบทบาท MLOps คือแนวทางปฏิบัติที่ช่วยให้กระบวนการพัฒนา, ปรับใช้, และดูแลรักษาระบบ ML เป็นไปอย่างอัตโนมัติและมีประสิทธิภาพ คล้ายกับการจัดการเซิร์ฟเวอร์เกมที่มีความเสถียรและสามารถอัปเดตเนื้อหาใหม่ๆ ได้อย่างต่อเนื่อง
การมี Pipeline สำหรับการพัฒนาและ Deploy โมเดลที่ชัดเจน ช่วยให้องค์กรสามารถตอบสนองต่อการเปลี่ยนแปลงของข้อมูลหรือความต้องการทางธุรกิจได้อย่างรวดเร็ว ไม่ว่าจะเป็นการปรับปรุงโมเดลเดิม หรือการนำโมเดลใหม่เข้ามาแทนที่ โดยไม่ส่งผลกระทบต่อระบบที่ทำงานอยู่
# ตัวอย่าง: ส่วนหนึ่งของ MLOps Pipeline สำหรับการ Deploy โมเดล AI บน Cloud
# ไฟล์: .github/workflows/deploy-model.yml (สำหรับ GitHub Actions)

name: Deploy ML Model to Production

on:
  push:
    branches:
      - main
    paths:
      - 'model_training/**' # Trigger เมื่อมีการเปลี่ยนแปลงในโฟลเดอร์โมเดล
      - 'deployment/**'

jobs:
  deploy_model:
    runs-on: ubuntu-latest
    environment: production # ระบุสภาพแวดล้อม Production
    steps:
      - name: Checkout repository
        uses: actions/checkout@v3

      - name: Setup Python
        uses: actions/setup-python@v4
        with:
          python-version: '3.9'

      - name: Install dependencies
        run: pip install -r requirements.txt

      - name: Configure AWS Credentials # ตัวอย่างการกำหนดค่าสำหรับ AWS
        uses: aws-actions/configure-aws-credentials@v1
        with:
          aws-access-key-id: ${{ secrets.AWS_ACCESS_KEY_ID }}
          aws-secret-access-key: ${{ secrets.AWS_SECRET_ACCESS_KEY }}
          aws-region: ap-southeast-1 # Region ยอดนิยมในไทย

      - name: Build Docker image for model inference
        run: |
          docker build -t my-ml-inference-image ./deployment/docker

      - name: Push Docker image to ECR
        run: |
          aws ecr get-login-password --region ap-southeast-1 | docker login --username AWS --password-stdin 123456789012.dkr.ecr.ap-southeast-1.amazonaws.com
          docker tag my-ml-inference-image:latest 123456789012.dkr.ecr.ap-southeast-1.amazonaws.com/my-ml-repo:latest
          docker push 123456789012.dkr.ecr.ap-southeast-1.amazonaws.com/my-ml-repo:latest

      - name: Deploy model to SageMaker Endpoint # ตัวอย่างการ Deploy ไปยัง AWS SageMaker
        id: deploy
        run: |
          # ใช้ Python script หรือ AWS CLI เพื่อสร้าง/อัปเดต Endpoint
          python ./deployment/deploy_sagemaker.py \
            --model-name "my-product-classifier" \
            --image-uri "123456789012.dkr.ecr.ap-southeast-1.amazonaws.com/my-ml-repo:latest" \
            --instance-type "ml.t2.medium" \
            --instance-count 1
        env:
          MODEL_VERSION: ${{ github.sha }} # ใช้ Git SHA เป็น Version ID ของโมเดล

      - name: Verify deployment (optional)
        run: echo "Model deployment initiated. Check AWS SageMaker console for status."
โค้ด YAML ด้านบนจำลองขั้นตอนการสร้างและ Deploy โมเดล AI ไปยัง Production Environment โดยใช้ GitHub Actions และ AWS SageMaker ซึ่งเป็นตัวอย่างที่แสดงให้เห็นถึงการผสานรวมเครื่องมือและกระบวนการ MLOps เพื่อให้การจัดการโมเดลเป็นไปอย่างมีระบบและยั่งยืน
ในการนำเทคโนโลยีหรือแนวปฏิบัตินี้ไปปรับใช้จริง ควรคำนึงถึง Security Hardening, Observability และการทดสอบแบบ Automated เสมอ เพื่อความเสถียรสูงสุดในระดับ Production
มุมมองสำหรับนักพัฒนาและองค์กรไทย
บทเรียนจาก Neverwinter Nights ชี้ให้เห็นว่าการสร้าง AI ที่ยั่งยืนและมีผลกระทบนั้น ไม่ได้ขึ้นอยู่กับความสามารถในการสร้าง “โมเดลที่ดีที่สุด” เพียงอย่างเดียว แต่ต้องพิจารณาถึง Ecosystem โดยรวม:
1. **เน้นการใช้ประโยชน์จาก Open-Source และ Community:** นักพัฒนาไทยไม่จำเป็นต้องสร้างทุกอย่างจากศูนย์ มีโมเดล Pre-trained สำหรับภาษาไทยและงานอื่นๆ อีกมากมายบน Hugging Face Hub หรือ GitHub ที่พร้อมให้เรานำไปใช้และปรับแต่ง การเข้าร่วมหรือสร้างชุมชน AI ในไทยจะช่วยให้เกิดการแบ่งปันความรู้และทรัพยากร
2. **พัฒนาทักษะการปรับแต่งและต่อยอด (Fine-tuning & Customization):** ความสามารถในการนำโมเดล Pre-trained มาปรับให้เข้ากับข้อมูลและบริบทเฉพาะของไทย คือทักษะสำคัญที่จะสร้างมูลค่าทางธุรกิจได้จริง การเข้าใจถึงวิธีการปรับเปลี่ยนโครงสร้างโมเดล, การเตรียมข้อมูลอย่างมีคุณภาพ, และการเลือกพารามิเตอร์ที่เหมาะสมสำหรับการ Fine-tuning จะเป็นกุญแจสำคัญ
3. **ลงทุนใน MLOps และ Infrastructure ที่แข็งแกร่ง:** การนำ AI ไปใช้ในระดับองค์กรต้องอาศัยโครงสร้างพื้นฐานที่รองรับตั้งแต่การพัฒนา, การทดสอบ, การ Deploy, ไปจนถึงการ Monitoring การลงทุนใน MLOps Tools และแพลตฟอร์ม Cloud (เช่น AWS, GCP, Azure) ที่สามารถจัดการวงจรชีวิตของ AI ได้อย่างมีประสิทธิภาพ จะช่วยให้ AI ไม่ใช่แค่ “โปรเจกต์นำร่อง” แต่เป็นส่วนหนึ่งของการดำเนินงานที่ยั่งยืน
4. **สร้างและสนับสนุน Ecosystem AI ในประเทศ:** เช่นเดียวกับชุมชน NWN ที่ช่วยให้เกมอยู่รอดได้ ชุมชน AI ในไทยสามารถมีบทบาทสำคัญในการพัฒนา AI ที่ตอบโจทย์บริบทท้องถิ่นได้ดีขึ้น ไม่ว่าจะเป็นการสร้าง Dataset ภาษาไทยที่มีคุณภาพ, การพัฒนาโมเดลเฉพาะทางสำหรับอุตสาหกรรมในประเทศ, หรือการจัดกิจกรรมแลกเปลี่ยนความรู้
ในท้ายที่สุด ความสำเร็จที่แท้จริงของการพัฒนา AI ในประเทศไทย ไม่ใช่การสร้างโมเดลที่ซับซ้อนที่สุด หรือทำลายสถิติโลก แต่คือการสร้างระบบนิเวศที่เอื้อต่อการสร้างสรรค์, การปรับแต่ง, และการนำ AI ไปใช้ประโยชน์ในชีวิตจริงได้อย่างยั่งยืน ด้วยเครื่องมือที่เหมาะสม, ชุมชนที่เข้มแข็ง, และความเข้าใจในพลังของการต่อยอด เราจะสามารถปลดล็อกศักยภาพของ AI ให้เป็นมากกว่าแค่เทคโนโลยีใหม่ แต่เป็นรากฐานของการเติบโตในอนาคต
ที่มา: วิเคราะห์และเรียบเรียงเพิ่มเติมจาก Ars Technica