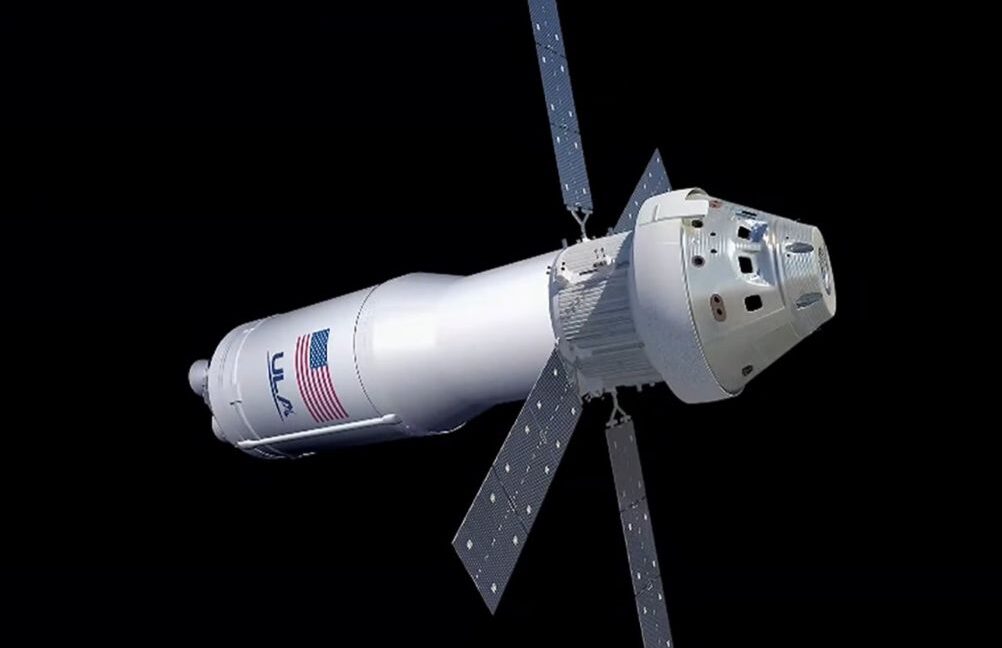
ในโลกของการพัฒนาเทคโนโลยี ไม่ว่าจะเป็นการส่งมนุษย์ไปสำรวจดวงจันทร์ หรือการสร้างระบบปัญญาประดิษฐ์ที่เปลี่ยนแปลงวิถีชีวิต มักมีแก่นแท้ของความสำเร็จที่คล้ายคลึงกัน นั่นคือการจัดการโครงการที่มีประสิทธิภาพ การจัดสรรทรัพยากรที่เหมาะสม และการได้รับการสนับสนุนจากผู้มีส่วนได้ส่วนเสียอย่างต่อเนื่อง บทความล่าสุดจาก Ars Technica ที่พูดถึงการอัปเดตแผนการส่งยานลงจอดบนดวงจันทร์ของ NASA และการแก้ไขปัญหาเรื้อรังของยาน Orion ได้เน้นย้ำประเด็นสำคัญนี้ด้วยประโยคที่ว่า “We have the mandate, we have the resources, and the support from our stakeholders.”
ประโยคสั้นๆ นี้แม้จะมาจากบริบทของอุตสาหกรรมอวกาศ แต่กลับสะท้อนถึงหลักการพื้นฐานที่สำคัญยิ่งต่อความสำเร็จของโครงการ AI/Machine Learning (ML) ในทุกระดับ โดยเฉพาะอย่างยิ่งสำหรับนักพัฒนาและองค์กรในประเทศไทยที่กำลังเร่งเครื่องก้าวสู่ยุคดิจิทัล บทความนี้จะเจาะลึกถึงความหมายของ “พันธกิจ ทรัพยากร และการสนับสนุน” ในบริบทของ AI/ML พร้อมถอดบทเรียนจากความท้าทายและโอกาสที่เราพบเจอ เพื่อสร้างรากฐานที่แข็งแกร่งสำหรับการพัฒนา AI ที่ยั่งยืน
แก่นแท้ของความสำเร็จ: พันธกิจ ทรัพยากร และการสนับสนุนในโครงการ AI/ML
ความสำเร็จของโครงการใดๆ ก็ตาม ไม่ว่าจะเป็นโครงการยักษ์ใหญ่ของ NASA หรือโครงการ AI ขนาดเล็กในองค์กรไทย ล้วนมีรากฐานมาจากสามเสาหลักนี้ การนำหลักคิดนี้มาประยุกต์ใช้กับ AI/ML จะช่วยให้เรามองเห็นภาพรวมและวางแผนได้อย่างมีประสิทธิภาพมากขึ้น
การกำหนดพันธกิจ (Mandate) ที่ชัดเจนในโครงการ AI/ML
พันธกิจคือเป้าหมายหลักที่ชัดเจนและจับต้องได้ ซึ่งเป็นตัวขับเคลื่อนและกำหนดทิศทางของโครงการทั้งหมด ในบริบทของ AI/ML พันธกิจไม่ใช่แค่การ “อยากใช้ AI” แต่เป็นการระบุปัญหาทางธุรกิจที่ AI สามารถแก้ไขได้ หรือโอกาสทางธุรกิจที่ AI สามารถสร้างขึ้นมาได้
* **ตัวอย่างในไทย:** หากองค์กรค้าปลีกในไทยต้องการนำ AI มาใช้ พันธกิจที่ชัดเจนอาจเป็นการ “ลดสินค้าคงคลังที่ค้างสต็อกลง 15% ภายใน 6 เดือน โดยใช้โมเดลพยากรณ์ความต้องการสินค้า” หรือ “เพิ่มยอดขายส่วนบุคคล (personalized sales) ผ่านการแนะนำสินค้าด้วย AI จำนวน 10% สำหรับลูกค้าออนไลน์” การมีเป้าหมายที่เฉพาะเจาะจง วัดผลได้ และเชื่อมโยงกับคุณค่าทางธุรกิจโดยตรง จะช่วยให้นักพัฒนา AI สามารถเลือกเทคนิค โมเดล และชุดข้อมูลที่เหมาะสมได้ ไม่ใช่แค่การลองผิดลองถูก
* **ความท้าทาย:** บ่อยครั้งที่โครงการ AI ล้มเหลวเพราะขาดพันธกิจที่ชัดเจน ผู้บริหารอาจต้องการ “มี AI” โดยไม่มีความเข้าใจลึกซึ้งว่า AI จะไปตอบโจทย์ธุรกิจใด หรือนักพัฒนาอาจสร้างโมเดลที่ซับซ้อนแต่ไม่สามารถนำไปใช้แก้ปัญหาจริงได้ การสื่อสารที่ชัดเจนตั้งแต่ต้นระหว่างทีมธุรกิจและทีมเทคนิคจึงเป็นสิ่งสำคัญอย่างยิ่ง
การจัดสรรทรัพยากร (Resources) อย่างชาญฉลาด: ไม่ใช่แค่เงินทุน
ทรัพยากรสำหรับโครงการ AI/ML นั้นครอบคลุมมากกว่างบประมาณเพียงอย่างเดียว มันรวมถึงบุคลากรที่มีความสามารถ ข้อมูลที่มีคุณภาพ โครงสร้างพื้นฐานทางคอมพิวเตอร์ และเวลา
* **บุคลากร:** ในประเทศไทย การหา Data Scientist, ML Engineer, หรือ MLOps Engineer ที่มีประสบการณ์ยังคงเป็นความท้าทาย องค์กรต้องพิจารณาการลงทุนในการพัฒนาบุคลากรภายใน การสร้างทีมข้ามสายงาน (cross-functional teams) ที่ประกอบด้วยผู้เชี่ยวชาญด้านโดเมน (domain experts) และผู้เชี่ยวชาญด้าน AI หรือการร่วมมือกับสถาบันการศึกษาและที่ปรึกษาภายนอก
* **ข้อมูล:** ข้อมูลคือหัวใจของ AI “Data is the new oil” ไม่ใช่แค่คำกล่าวอ้าง ข้อมูลที่มีคุณภาพ สะอาด ปริมาณเพียงพอ และเข้าถึงได้ คือสิ่งจำเป็นอย่างยิ่งสำหรับการฝึกโมเดล AI ในบริบทไทย หลายองค์กรมีข้อมูลอยู่แล้ว แต่กระจัดกระจาย หรืออยู่ในรูปแบบที่ไม่พร้อมใช้ การลงทุนใน Data Engineering, Data Governance และการสร้าง Data Lake/Data Warehouse จึงเป็นสิ่งสำคัญก่อนที่จะเริ่มโครงการ AI ขนาดใหญ่
* **โครงสร้างพื้นฐาน:** การประมวลผลสำหรับ AI โดยเฉพาะ Deep Learning ต้องการพลังงานคอมพิวเตอร์สูง การเลือกใช้ Cloud Computing (เช่น AWS, GCP, Azure) ที่มีความยืดหยุ่นและปรับขนาดได้จึงเป็นทางเลือกยอดนิยมสำหรับองค์กรไทย ช่วยลดภาระการลงทุนใน Hardware และการดูแลระบบ
* **เวลา:** AI ไม่ใช่เวทมนตร์ การพัฒนาและปรับใช้ AI ต้องการเวลาสำหรับการสำรวจข้อมูล การสร้างโมเดล การทดสอบ และการปรับปรุงอย่างต่อเนื่อง การกำหนดกรอบเวลาที่ไม่สมจริงอาจนำไปสู่ความล้มเหลวได้
การสร้างฉันทามติและการสนับสนุน (Support) จากผู้มีส่วนได้ส่วนเสีย
โครงการ AI ที่จะประสบความสำเร็จได้ต้องได้รับการสนับสนุนจากทุกฝ่ายที่เกี่ยวข้อง ตั้งแต่ผู้บริหารระดับสูง ผู้ใช้งาน ไปจนถึงทีม IT และฝ่ายกฎหมาย
* **ผู้บริหาร:** ผู้บริหารต้องเข้าใจถึงศักยภาพและข้อจำกัดของ AI และเต็มใจที่จะลงทุนและสนับสนุนการเปลี่ยนแปลงที่อาจเกิดขึ้น การสื่อสารถึง ROI (Return on Investment) ที่ชัดเจนและการนำเสนอผลลัพธ์ที่เป็นรูปธรรมในระยะแรก (Quick Wins) จะช่วยสร้างความเชื่อมั่นได้
* **ผู้ใช้งาน:** การนำ AI มาใช้มักส่งผลกระทบต่อกระบวนการทำงานเดิม ผู้ใช้งานต้องได้รับการฝึกอบรมและทำความเข้าใจถึงประโยชน์ของ AI ที่จะช่วยให้งานของพวกเขามีประสิทธิภาพมากขึ้น การออกแบบระบบที่ใช้งานง่ายและมี User Experience ที่ดีจึงเป็นสิ่งสำคัญ
* **ทีม IT และฝ่ายกฎหมาย:** ทีม IT ต้องเตรียมพร้อมสำหรับโครงสร้างพื้นฐาน การบูรณาการระบบ และความปลอดภัยของข้อมูล ขณะที่ฝ่ายกฎหมายต้องพิจารณาประเด็นความเป็นส่วนตัวของข้อมูล (PDPA) และจริยธรรมของ AI การทำงานร่วมกันตั้งแต่ต้นจะช่วยป้องกันปัญหาในอนาคต

ถอดบทเรียนจาก “ปัญหารบกวนใจ” สู่การพัฒนา AI ที่ยั่งยืน
เช่นเดียวกับที่ NASA ต้องแก้ไข “long-festering Orion issue” ในโครงการอวกาศ โครงการ AI/ML ก็มักเผชิญกับ “ปัญหารบกวนใจ” ที่สะสมมานาน ซึ่งหากไม่ได้รับการแก้ไข ก็จะขัดขวางความก้าวหน้า ปัญหาเหล่านี้มักเกี่ยวข้องกับคุณภาพข้อมูล เทคนิคอลเดบท์ (Technical Debt) และการขาด MLOps ที่เหมาะสม
* **ปัญหาคุณภาพข้อมูล:** เป็นปัญหาคลาสสิกที่พบได้บ่อยที่สุด ข้อมูลที่ไม่ถูกต้อง ขาดหาย ไม่สอดคล้องกัน หรือมี Bias จะนำไปสู่โมเดล AI ที่มีประสิทธิภาพต่ำและตัดสินใจผิดพลาด การลงทุนใน Data Cleansing, Data Validation และ Data Governance ตั้งแต่ต้นจะช่วยป้องกันปัญหานี้ได้
* **Technical Debt:** เกิดจากการเร่งสร้างโมเดลโดยไม่ได้คำนึงถึงความสามารถในการบำรุงรักษา ความสามารถในการขยายขนาด หรือการนำไปใช้งานจริง (Productionization) เช่น การเขียนโค้ดที่ซับซ้อนโดยไม่มีเอกสารประกอบ การใช้ไลบรารีที่ล้าสมัย หรือการไม่มีระบบ Version Control ที่ดี
* **ขาด MLOps:** การนำ AI ขึ้น Production และบำรุงรักษาในระยะยาวเป็นความท้าทาย MLOps (Machine Learning Operations) คือแนวทางปฏิบัติที่ช่วยจัดการวงจรชีวิตของโมเดล AI ตั้งแต่การพัฒนา การปรับใช้ การเฝ้าระวัง ไปจนถึงการปรับปรุง ซึ่งช่วยแก้ไขปัญหา Technical Debt และทำให้ AI สามารถทำงานได้อย่างยั่งยืน
**ตัวอย่างโค้ด: การจัดการปัญหาคุณภาพข้อมูลด้วย Data Validation**
การใช้เครื่องมือ Data Validation เป็นหนึ่งในวิธีที่ช่วยแก้ไขปัญหาข้อมูลเรื้อรังตั้งแต่ต้น ตัวอย่างเช่น การใช้ไลบรารี `pandera` ใน Python เพื่อกำหนด Schema ของข้อมูลที่คาดหวัง
import pandas as pd
from pandera import DataFrameSchema, Column, Check, Index

# กำหนด Schema สำหรับข้อมูลการขายที่คาดหวัง
# เพื่อให้มั่นใจว่าข้อมูลมีคุณภาพก่อนนำไปใช้ในโมเดล AI
sales_data_schema = DataFrameSchema(
    columns={
        "customer_id": Column(int, Check.greater_than(0), unique=True),
        "product_id": Column(str, Check.str_matches(r"PROD-\d{4}")),
        "quantity": Column(int, Check.greater_than(0)),
        "price_per_unit": Column(float, Check.greater_than(0.0)),
        "transaction_date": Column(pd.Timestamp),
        "payment_method": Column(str, Check.isin(["Credit Card", "Cash", "Bank Transfer"]))
    },
    index=Index(int),
    strict=True # ไม่อนุญาตให้มีคอลัมน์ที่ไม่ตรงตามที่กำหนด
)

def validate_sales_data(file_path: str):
    """
    อ่านไฟล์ CSV และตรวจสอบความถูกต้องของข้อมูลตาม sales_data_schema
    """
    try:
        df = pd.read_csv(file_path)
        # แปลงคอลัมน์วันที่ให้เป็นรูปแบบ Timestamp ก่อนตรวจสอบ
        df['transaction_date'] = pd.to_datetime(df['transaction_date'])
        sales_data_schema.validate(df, lazy=True)
        print(f"✅ ข้อมูลในไฟล์ '{file_path}' มีความถูกต้องตาม Schema")
        return True
    except Exception as e:
        print(f"❌ การตรวจสอบข้อมูลล้มเหลวสำหรับไฟล์ '{file_path}':")
        print(e)
        return False

if __name__ == "__main__":
    # สร้างข้อมูลตัวอย่างที่มีคุณภาพดี
    clean_data = pd.DataFrame({
        "customer_id": [1001, 1002, 1003],
        "product_id": ["PROD-0001", "PROD-0002", "PROD-0003"],
        "quantity": [2, 1, 3],
        "price_per_unit": [150.50, 200.00, 75.25],
        "transaction_date": ["2023-01-01", "2023-01-05", "2023-01-10"],
        "payment_method": ["Credit Card", "Cash", "Bank Transfer"]
    })
    clean_data.to_csv("clean_sales.csv", index=False)
    validate_sales_data("clean_sales.csv")

    print("\n" + "="*50 + "\n")

    # สร้างข้อมูลตัวอย่างที่มีปัญหา
    problem_data = pd.DataFrame({
        "customer_id": [1001, 1002, 1002], # customer_id ซ้ำกัน
        "product_id": ["PROD-0001", "PROD-ABCD", "PROD-0003"], # product_id ไม่ตรงรูปแบบ
        "quantity": [2, 0, 3], # quantity เป็น 0
        "price_per_unit": [150.50, -20.00, 75.25], # price_per_unit ติดลบ
        "transaction_date": ["2023-01-01", "invalid-date", "2023-01-10"], # transaction_date ไม่ถูกต้อง
        "payment_method": ["Credit Card", "QR Pay", "Bank Transfer"] # payment_method ไม่ตรงค่าที่กำหนด
    })
    problem_data.to_csv("problematic_sales.csv", index=False)
    validate_sales_data("problematic_sales.csv")
โค้ดนี้แสดงให้เห็นว่าการลงทุนเพียงเล็กน้อยในการสร้างระบบ Data Validation สามารถช่วยตรวจจับปัญหาข้อมูลได้ตั้งแต่ต้น ป้องกันไม่ให้ปัญหาเหล่านี้กลายเป็น “ปัญหารบกวนใจ” ที่ส่งผลกระทบต่อประสิทธิภาพของโมเดล AI ในระยะยาว

AI/ML ในบริบทประเทศไทย: โอกาสและความท้าทาย
ประเทศไทยมีศักยภาพสูงในการนำ AI มาใช้ในหลากหลายอุตสาหกรรม ไม่ว่าจะเป็นภาคเกษตรกรรม การแพทย์ การเงิน การท่องเที่ยว หรือการค้าปลีก อย่างไรก็ตาม เราก็ยังเผชิญกับความท้าทายเฉพาะตัว
* **โอกาส:**
* **ภาคเกษตรกรรม:** AI สามารถช่วยวิเคราะห์ข้อมูลดินฟ้าอากาศ คาดการณ์ผลผลิต ตรวจจับโรคพืช และเพิ่มประสิทธิภาพการเพาะปลูก ซึ่งเป็นประโยชน์อย่างมากต่อเศรษฐกิจของประเทศ
* **การแพทย์:** AI ช่วยในการวินิจฉัยโรคเบื้องต้น การวิเคราะห์ภาพทางการแพทย์ การค้นคว้ายา และการดูแลผู้สูงอายุ
* **การบริการและการท่องเที่ยว:** Chatbot, ระบบแนะนำส่วนบุคคล, การวิเคราะห์ความพึงพอใจลูกค้า ล้วนเป็นสิ่งที่ AI ทำได้ดี
* **ภาครัฐ:** การนำ AI มาใช้เพื่อปรับปรุงบริการสาธารณะ เช่น การจัดการจราจร การวิเคราะห์ข้อมูลอาชญากรรม หรือการจัดสรรทรัพยากร
* **ความท้าทาย:**
* **ขาดแคลนบุคลากร:** ความต้องการผู้เชี่ยวชาญ AI มีสูงกว่าอุปทาน
* **คุณภาพข้อมูล:** ข้อมูลในหลายองค์กรยังไม่เป็นระบบ ขาดการจัดการที่ดี และมีคุณภาพต่ำ
* **การลงทุน:** การลงทุนในโครงสร้างพื้นฐานและบุคลากร AI ยังไม่แพร่หลายเท่าที่ควร โดยเฉพาะใน SME
* **จริยธรรมและกฎหมาย:** ประเด็นด้านความเป็นส่วนตัว ความโปร่งใส และความรับผิดชอบของ AI ยังเป็นเรื่องที่ต้องมีการพัฒนาและบังคับใช้
**ตารางเปรียบเทียบ: ปัจจัยสู่ความสำเร็จของโครงการ AI ในองค์กรไทย**
| ปัจจัย/ความท้าทาย | องค์กรขนาดใหญ่ในไทย (Enterprise) | SME/Startup ในไทย |
|---|---|---|
| พันธกิจ/เป้าหมาย | ชัดเจน แต่ซับซ้อน ต้องผ่านหลายฝ่าย อิง ROI เป็นหลัก | ยืดหยุ่น เปลี่ยนแปลงได้เร็ว เน้นการแก้ปัญหาเฉพาะหน้า/สร้างนวัตกรรม |
| ทรัพยากรบุคคล | เข้าถึงผู้เชี่ยวชาญได้ง่ายกว่า (แต่การดึงดูด/รักษาเป็นสิ่งท้าทาย) อาจมีทีมเฉพาะทาง | ทรัพยากรจำกัด, ต้องพึ่งพาทีมเล็ก/ภายนอก หรือ Full-stack Data Scientist |
| ข้อมูล | มีข้อมูลมหาศาล (แต่คุณภาพและความเป็นส่วนตัวเป็นประเด็นสำคัญ) | ข้อมูลจำกัด, อาจต้องหาแหล่งภายนอก หรือสร้างขึ้นใหม่ (Synthetic Data) |
| โครงสร้างพื้นฐาน | มีระบบเดิมที่ต้องบูรณาการ (Legacy systems), อาจมี On-premise Data Center | เริ่มต้นได้ง่ายกว่า, เน้น Cloud-native และ Microservices |
| การสนับสนุนผู้บริหาร | จำเป็นต้องมีการนำเสนอ ROI ที่ชัดเจนและเป็นรูปธรรม การเปลี่ยนแปลงต้องเป็นแบบ Top-down | มักจะใกล้ชิดและเข้าใจเทคโนโลยีใหม่ๆ มากกว่า การตัดสินใจรวดเร็ว |
| ความคล่องตัว (Agility) | มักจะช้ากว่าด้วยขั้นตอนและระเบียบที่ซับซ้อน | มีความคล่องตัวสูง, สามารถทดลองและปรับเปลี่ยนได้เร็ว |
| ความเสี่ยงด้าน Regulatory | สูงกว่า, ต้องระมัดระวัง PDPA และกฎระเบียบเฉพาะอุตสาหกรรม | ต่ำกว่าเล็กน้อย (ขึ้นอยู่กับธุรกิจ), แต่ต้องตระหนักถึง PDPA |
ในการนำเทคโนโลยีหรือแนวปฏิบัตินี้ไปปรับใช้จริง ควรคำนึงถึง Security Hardening, Observability และการทดสอบแบบ Automated เสมอ เพื่อความเสถียรสูงสุดในระดับ Production
มุมมองสำหรับนักพัฒนาและองค์กรไทย
จากการถอดบทเรียนจาก NASA และการวิเคราะห์บริบท AI/ML ในประเทศไทย มีข้อเสนอแนะสำหรับนักพัฒนาและองค์กรดังนี้:
* **สำหรับนักพัฒนา:**
* **เน้น Business Acumen:** เข้าใจปัญหาทางธุรกิจให้ลึกซึ้ง ไม่ใช่แค่ทักษะทางเทคนิค การสร้างโมเดลที่ตอบโจทย์ธุรกิจคือสิ่งสำคัญกว่าโมเดลที่ซับซ้อนแต่ใช้ไม่ได้จริง
* **พัฒนาทักษะ MLOps:** การนำโมเดลขึ้น Production และดูแลรักษาเป็นทักษะที่ตลาดต้องการอย่างมาก
* **เรียนรู้ Data Engineering:** ทักษะในการจัดการข้อมูล การทำความสะอาด และการสร้าง Data Pipeline เป็นพื้นฐานสำคัญของงาน AI
* **สร้างเครือข่าย:** เข้าร่วมชุมชน AI/ML ในไทย แลกเปลี่ยนความรู้และประสบการณ์
* **สำหรับองค์กร:**
* **ลงทุนใน Data Governance และ Data Engineering:** สร้างรากฐานข้อมูลที่แข็งแกร่งก่อนเริ่มโครงการ AI ขนาดใหญ่
* **เริ่มต้นด้วย “Quick Wins”:** เลือกโครงการ AI ขนาดเล็กที่สามารถแสดงผลลัพธ์ที่เป็นรูปธรรมได้เร็ว เพื่อสร้างความเชื่อมั่นและแรงผลักดัน
* **สร้างทีมข้ามสายงาน:** ส่งเสริมการทำงานร่วมกันระหว่างทีมธุรกิจ ทีม IT และทีม AI เพื่อให้เข้าใจเป้าหมายและข้อจำกัดของกันและกัน
* **ลงทุนในการพัฒนาบุคลากร:** จัดอบรมภายใน ส่งเสริมการเรียนรู้ และสร้างวัฒนธรรมที่สนับสนุนการทดลองและนวัตกรรม
* **พิจารณา Ethical AI:** สร้างกรอบการทำงานด้านจริยธรรมและความรับผิดชอบของ AI ตั้งแต่ต้น เพื่อป้องกันปัญหาในอนาคต
สรุปแล้ว การที่ NASA ประสบความสำเร็จในการอัปเดตแผนการสำรวจดวงจันทร์และแก้ไขปัญหาสำคัญ ไม่ใช่เพียงเพราะพวกเขามีเทคโนโลยีที่ล้ำสมัย แต่เป็นเพราะพวกเขามี “พันธกิจที่ชัดเจน ทรัพยากรที่เหมาะสม และการสนับสนุนจากผู้มีส่วนได้ส่วนเสีย” หลักการเหล่านี้เป็นสากลและสามารถนำมาปรับใช้ได้อย่างมีประสิทธิภาพในโลกของ AI/ML สำหรับนักพัฒนาและองค์กรไทย การยึดมั่นในหลักการเหล่านี้ จะเป็นกุญแจสำคัญในการสร้างสรรค์นวัตกรรม AI ที่ไม่เพียงแค่ “ทำงานได้” แต่ “สร้างคุณค่า” และ “ยั่งยืน” อย่างแท้จริง
ที่มา: วิเคราะห์และเรียบเรียงเพิ่มเติมจาก Ars Technica